PubChem官网:全球规模最大、免费向公众开放的化学信息资源库
什么是PubChem?
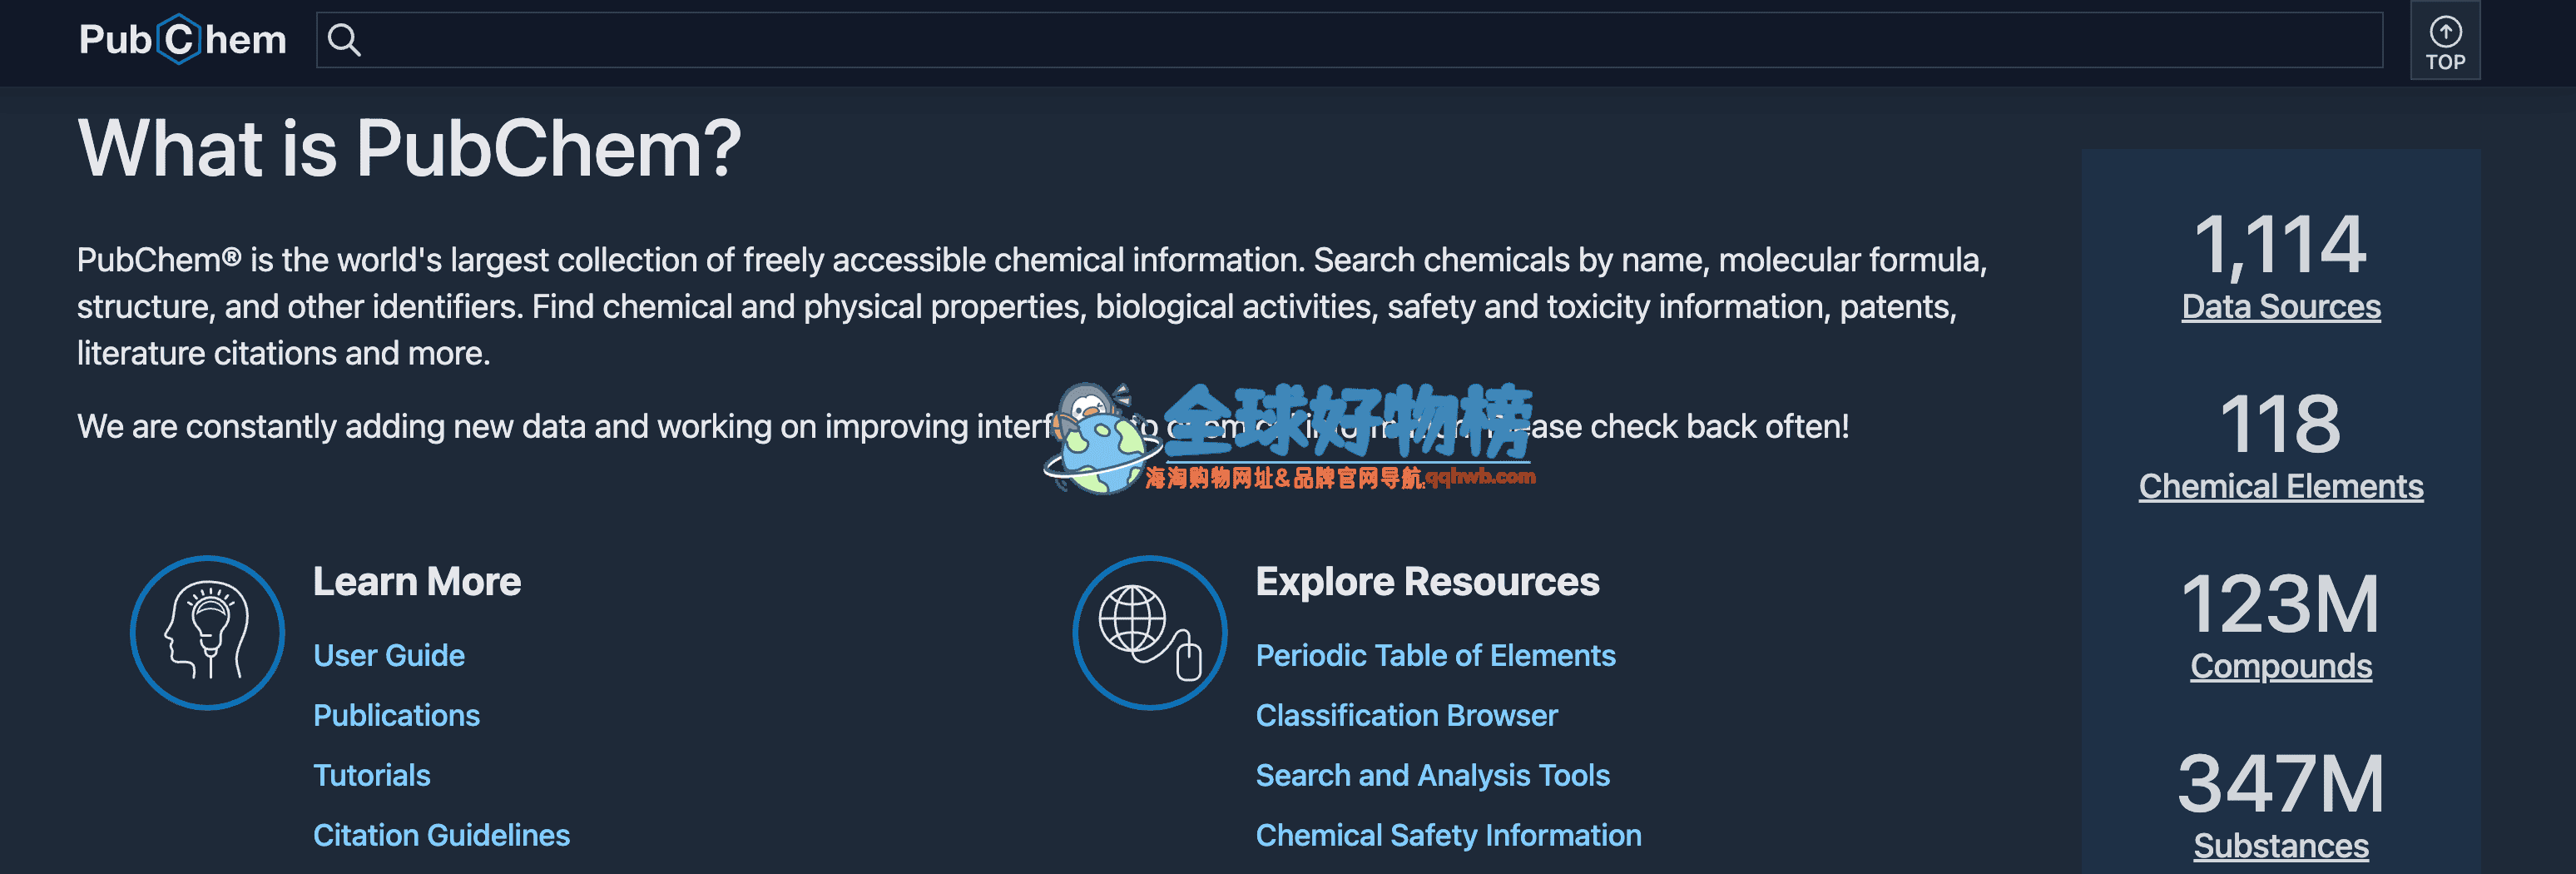
PubChem数据库是由美国国立卫生研究院(NIH)下属的国家生物技术信息中心(NCBI)建立并维护的全球规模最大、免费向公众开放的化学信息资源库,其核心特色在于将化学物质的结构数据、物理化学性质、生物活性、安全与毒性信息、专利及科技文献进行了前所未有的深度整合。截至2026年5月的最新统计,该数据库汇集了来自超过1,100个数据源的逾1.23亿种化合物、3.47亿种物质、2.99亿项生物活性测试结果、4,500万篇文献及8,300万条专利记录,规模极其庞大。它的主要功能围绕三大互相关联的数据库展开:Substance数据库收纳由全球数据贡献者提交的原始化学描述,Compound数据库则提供经过标准化和去重处理的唯一化学结构,而BioAssay数据库存储了海量的高通量筛选实验数据。用户不仅可以通过化学名称、分子式、结构式或CAS号等多种标识符进行精确检索,还能利用其强大的化学结构搜索工具,进行二维或三维的相似性、子结构及超结构搜索,从而快速识别具有特定分子骨架或空间构象的化合物。此外,PubChem通过构建蛋白质、基因、通路和分类学等靶点中心的数据合集,架起了化学与生物学之间的桥梁,使研究人员能够便捷地查询调控特定基因或靶向特定蛋白的药物分子。其元素周期表页面与分类浏览器为教育用户提供了直观的探索入口,而PUG-REST和PUG-View等编程访问接口则支持大规模数据挖掘与自动化分析,全面满足了从基础化学教育到前沿药物发现等不同层次的科研需求,更多请看: 学术导航: https://xueshuyu.com/。
PubChem官网: https://pubchem.ncbi.nlm.nih.gov/
PubChem数据库深度测评:全球最大的免费化学信息宝藏,你挖掘对了吗?
一、 引言
你是否曾在实验室里,为了查找一个化合物的安全数据表(SDS),在多个搜索引擎和付费数据库之间来回奔波?是否在进行药物筛选时,因为无法快速获取数百万化合物的生物活性数据,导致研究周期被无限拉长?又或者在撰写论文时,为了引用一个准确的化学结构式,在不同的网站上反复核对,却仍然担心数据源的权威性?
这些痛点,对于化学、生物医药、环境科学等领域的从业者来说,几乎每天都在上演。化学信息如同科研的基石,但它的分散、异构和获取门槛,常常成为阻碍创新的隐形壁垒。就在此刻,一个由美国国立卫生研究院(NIH)背书的庞然大物——PubChem数据库,正以其前所未有的开放姿态,试图打破这一僵局。自2004年启动以来,它已从一个单纯的分子库项目,成长为全球规模最大、访问量最高的免费化学信息资源库之一。截至2026年6月,它收录了超过1.23亿个化合物、3.47亿种物质、2.99亿项生物活性数据,并整合了来自1114个数据源的信息,其体量之庞大,几乎覆盖了人类已知的化学世界。
本文将不仅仅是一份功能说明书,而是一次对PubChem数据库的全方位深度评测。我们将从它的核心价值出发,精准定位其目标用户与应用场景,手把手拆解其杀手级功能,分享真实的使用体验与隐藏技巧,并横向对比其他竞品。无论你是初涉科研的学生,还是经验丰富的行业专家,这篇指南都将帮助你重新认识并高效利用这座免费的化学信息宝库。
二、 什么是PubChem数据库
PubChem,全称“公共化学数据库”,是全球最大的、免费向公众开放的化学信息资源库。它由美国国立卫生研究院(NIH)下属的国家生物技术信息中心(NCBI)开发和维护。你可以把它想象成一个关于化学分子的“超级百科全书”+“全球数据聚合器”。
它不仅仅存储化学结构式那么简单。PubChem的核心由三个互相关联的数据库组成:Substance(物质)、Compound(化合物)和BioAssay(生物测定)。Substance库是原始数据池,存放着全球各机构、公司、大学提交的化学样品信息,目前超过3.47亿条;Compound库则是经过标准化和去重处理的“精华版”化学结构库,包含了超过1.23亿个独特的化学结构;BioAssay库则记录了这些化合物在各种生物学实验中的活性测试结果,数据量高达2.99亿项。这三者如同一个稳固的三脚架,共同支撑起一个从“化学身份”到“生物功能”的完整知识体系。
无论你是想查询阿司匹林的理化性质、寻找一种新药分子的候选物、还是分析某种环境污染物的毒性数据,PubChem都能提供一个权威、综合且完全免费的入口。它彻底打破了化学信息获取的门槛,让前沿科学数据不再是少数付费机构的特权。

三、 目标客户和应用场景
PubChem的强大之处在于其普适性,但不同用户从中获取的价值维度截然不同。明确你的身份和需求,是高效利用它的第一步。
1. 核心目标客户画像
PubChem的用户群体横跨学术界、工业界、监管机构和普通公众。为了更精准地定位,我们将核心客户画像总结如下:
| 用户群体 | 所属行业/岗位 | 核心需求 | 推荐指数 |
|---|---|---|---|
| 学术研究人员 | 化学、生物学、药学、材料学、环境科学教授/博后/研究生 | 文献调研、寻找先导化合物、获取实验数据、论文引用、教学演示 | ★★★★★ |
| 药物研发人员 | 制药公司、生物技术公司的研发科学家 | 化合物库筛选、构效关系(SAR)分析、专利信息挖掘、靶点验证 | ★★★★★ |
| 计算化学/生物学家 | 高校或企业的CADD/AIDD部门 | 大规模数据下载、模型训练数据集构建、虚拟筛选、API自动化查询 | ★★★★★ |
| 监管与安全工程师 | 化学品监管机构(如EPA)、企业EHS部门、毒理学家 | 查询物质安全数据(SDS)、毒性信息、物理化学性质、法规合规性 | ★★★★☆ |
| 数据科学家/工程师 | 科技公司、数据服务提供商 | 通过API构建化学信息应用、知识图谱构建、大数据分析 | ★★★★☆ |
| 临床医生/药剂师 | 医院、药房 | 查询药物信息、相互作用、作用机制、临床指南链接 | ★★★☆☆ |
| 普通公众/学生 | 科普爱好者、K-12及大学本科生 | 了解日常化学品(如咖啡因、维生素)信息、完成作业、满足好奇心 | ★★★★☆ |
2. 典型应用场景一:药物化学家的“虚拟筛选与先导物发现”
对于一名药物化学家而言,时间是最宝贵的资源。传统的药物发现流程中,从海量分子中筛选出有活性的先导化合物,如同大海捞针。PubChem彻底改变了这一局面。
使用方式:研究员首先确定一个感兴趣的生物靶点,例如与阿尔茨海默症相关的乙酰胆碱酯酶(Acetylcholinesterase)。他可以直接在PubChem中搜索该靶点的蛋白名称,进入其Protein数据集合页面。页面会聚合所有与该靶点相关的生物活性测试数据,并按活性强度(如IC50)排序。研究员可以设定一个活性阈值(如IC50 < 1μM),一键筛选出所有高活性化合物。接着,他可以利用结构相似性搜索功能,以某个高活性分子为模板,在1.23亿个化合物库中寻找结构类似但可能具有更好药代动力学性质的分子。整个过程,从靶点分析到获得一批候选分子,可能只需要一个下午的时间,这在过去可能需要数月甚至数年。
效果:极大加速了“Hit-to-Lead”进程,降低了早期药物发现的门槛和成本。研究人员可以免费获取全球公开的生物活性数据,避免重复实验。
3. 典型应用场景二:环境毒理学家的“新兴污染物风险评估”
随着工业化进程,大量新型化学品(如全氟和多氟烷基物质PFAS、微塑料添加剂)进入环境,其潜在风险亟待评估。环境毒理学家需要快速了解这些物质的理化性质、环境归趋和毒性终点。
使用方式:以评估某种新型PFAS替代物为例,科学家可以在PubChem中通过SMILES结构式或化学名称进行精确检索。进入该化合物的摘要页面,他不仅能获得分子量、氢键供体/受体数、脂水分配系数(LogP)等预测其环境迁移性的关键参数,还能在安全与毒性(Safety and Toxicology)板块直接链接到来自EPA、NTP等权威机构的危害评估数据。更重要的是,通过专利和文献板块,他可以追踪该物质的生产厂商、工业用途以及最新的毒性研究论文,从而快速形成一份初步的风险评估报告。
效果:提供了一个一站式的信息枢纽,将分散在各国监管机构、学术论文和商业数据库中的信息聚合在一起,极大地提高了风险评估的效率和全面性。
4. 典型应用场景三:高校教师的“互动式化学教学”
化学教学不应只是枯燥的分子式和方程式。PubChem为化学、生物等学科的教师提供了一个强大的互动教学平台。
使用方式:在有机化学课上,教授可以现场打开PubChem的3D构象查看器,动态展示(R)-和(S)-布洛芬的空间结构差异,让学生直观理解手性异构的概念。在生物化学课上,教授可以利用PubChem元素周期表,点击任意元素,如铁(Fe),即可展示其在人体内的生物学作用、相关蛋白质、以及缺铁性贫血相关的信号通路。学生也可以通过分类浏览器,探索“天然产物”这一化学空间,了解黄酮类、萜类等天然化合物的结构多样性。课后,教授可以布置作业,让学生查找日常用品中某个化学物质的安全信息,培养其科学素养。
效果:将抽象的知识点与权威、可视化的数据连接,激发学生的学习兴趣,培养其数据检索和科学探究能力。
5. 不适合哪些人?
尽管PubChem功能强大,但它并非万能。以下几类用户可能会觉得它“不够用”或“不顺手”:
- 需要深度合成路线设计的高级用户:PubChem主要提供合成参考文献,但缺乏像SciFinder或Reaxys那样基于规则的逆合成分析工具(CAS Solutions的逆合成规划器)。如果你需要设计全新的合成路线,专业商业数据库是更好的选择。
- 进行严格的法规合规性审查的专家:PubChem聚合了安全数据,但其数据源多样,更新频率不一。对于需要满足特定法规(如REACH)的严格合规性审查,直接访问官方监管机构(如ECHA)的原始数据库更为可靠。
- 需要高级企业级功能的工业用户:例如,需要内部私有数据库集成、定制化分析面板、或与ELN(电子实验记录本)无缝衔接的功能,PubChem作为公共数据库无法提供。这类用户可能需要考虑商业级的化学信息学平台。
四、 核心功能深度拆解
本章是全文的核心,我们将以“手把手教学+深度评测”的方式,彻底解剖PubChem的杀手锏功能。这不仅是功能介绍,更是让你从“会用”到“精通”的进阶指南。
1. 杀手级功能一:多维化学结构搜索
如果说PubChem是一座宝库,那么结构搜索就是打开这座宝库最精准的钥匙。它远不止简单的“画个结构搜一下”,而是一套强大的分子查询语言。
功能介绍与操作步骤:
PubChem的结构搜索主要通过其内置的PubChem Sketcher(化学结构绘图板)进行。你可以绘制一个精确的分子骨架,然后选择以下三种核心搜索模式:
- Identity Search(精确搜索):寻找与你绘制的结构完全相同的分子,包括同位素、立体化学和电荷状态。这是最严格的搜索。
- 操作:绘制结构 -> 选择“Same” -> 搜索。
- 适用场景:确认一个已知化合物的唯一PubChem CID,或查找其所有相关的物质记录和供应商信息。
- Substructure Search(子结构搜索):寻找所有包含你绘制骨架的分子。你画了一个苯环,它会找出所有含苯环的化合物。
- 操作:绘制结构 -> 选择“Substructure” -> 搜索。
- 适用场景:从一个核心药效团出发,寻找所有包含该骨架的衍生物,进行构效关系(SAR)研究。
- Superstructure Search(超结构搜索):寻找所有被你绘制骨架所包含的分子。你画了一个复杂的分子,它会找出所有作为其结构片段的小分子。
- 操作:绘制结构 -> 选择“Superstructure” -> 搜索。
- 适用场景:研究一个复杂天然产物的代谢或降解产物。
高级技巧:相似性搜索
除了骨架搜索,2D和3D相似性搜索是发现新分子的利器。
- 2D Similarity:基于分子指纹(如PubChem Fingerprint)的Tanimoto系数打分。阈值可调(通常90%-100%),分数越高,二维结构越相似。这对于寻找具有类似骨架和官能团的“类似物”非常有效。
- 3D Similarity:基于分子形状和药效团特征的叠加。即使二维结构差异很大,但三维形状和关键相互作用位点相似,也可能具有相似的生物活性。这是发现全新骨架(Scaffold Hopping)的经典方法。
与同类功能对比:
| 功能维度 | PubChem | SciFinder-n | Reaxys |
|---|---|---|---|
| 搜索类型 | 精确、子结构、超结构、2D/3D相似性 | 精确、子结构、相似性、Markush检索 | 精确、子结构、相似性、基于反应的检索 |
| 绘图工具 | PubChem Sketcher (Web端,易用) | CAS Draw (功能强大,需学习) | Marvin JS (专业,功能丰富) |
| 3D相似性 | 强大且免费,支持形状和药效团 | 支持,但非核心亮点 | 支持,功能强大 |
| 结果规模 | 1.23亿化合物,覆盖面极广 | 2.04亿有机/无机物质,专利覆盖深 | 数千万化合物,反应数据强大 |
| 价格 | 完全免费 | 极其昂贵,按任务或年费订阅 | 极其昂贵,机构订阅 |
评测:PubChem的结构搜索在免费这个前提下,做到了极致。其3D相似性搜索能力尤其突出,是许多商业软件都无法免费提供的功能。唯一的短板在于对Markush结构(专利中常见的通用结构)检索的支持较弱,而这恰好是SciFinder-n的护城河。
2. 杀手级功能二:目标导向的生物学数据聚合
PubChem在2022年推出的Protein, Gene, Pathway, and Taxonomy Data Collections,是其从“化学数据库”向“化学生物学信息平台”进化的重要里程碑。这个功能彻底改变了用户获取生物活性数据的方式,从“以化合物为中心”转变为“以生物靶点为中心”。
功能介绍与操作步骤:
假设你是一名研究COVID-19的科学家,你的目标是找到能抑制SARS-CoV-2主蛋白酶(Mpro)的化合物。
- 传统方式:你需要先知道有哪些化合物可能具有活性,然后分别搜索这些化合物,在它们冗长的生物活性列表中,手动查找是否有针对Mpro的测试数据。效率极低,且容易遗漏。
- PubChem新方式:
- 在PubChem搜索框中输入“SARS-CoV-2 main protease”或相关基因名。
- 搜索结果会优先显示一个Protein或Gene数据集合的页面。
- 进入该页面,你会看到一个清晰的仪表盘,聚合了关于这个靶点的所有化学信息:
- BioAssays:列出所有针对该靶点的生物活性测试,并可直接按活性值(IC50, Ki等)排序和筛选。
- Active Compounds:直接列出在该靶点所有测试中表现出活性的化合物列表。
- Literature:关联了提及该靶点和相关化合物的PubMed文献。
- Pathways:展示了该靶点参与的信号通路。
- 你可以一键下载所有活性化合物的SMILES和活性数据,用于后续的QSAR建模或虚拟筛选。
真实使用感受与效率提升:
这个功能带来的效率提升是数量级的。过去需要数小时甚至数天的数据整合工作,现在可以在几分钟内完成。它像一个智能的“化学生物学数据管家”,自动帮你把散布在各个生物测定、文献和专利中的信息,按生物学靶点整理得井井有条。这对于从事靶点发现、药物再利用和化学生物学研究的科学家来说,价值无可估量。根据官方数据,该功能上线后,相关数据集合的月访问量迅速攀升,证明了市场对此类目标导向信息的巨大需求。
功能对比:PubChem vs ChEMBL vs BindingDB
| 功能维度 | PubChem | ChEMBL | BindingDB |
|---|---|---|---|
| 数据聚合模式 | 以靶点为中心的数据集合,也支持化合物中心 | 以靶点和化合物为中心,数据库结构清晰 | 以靶点-化合物相互作用为中心 |
| 数据广度 | 极广,整合了ChEMBL等众多数据库 | 高度精选,主要来自文献和部分高通量筛选 | 深度精选,专注于已知的蛋白-配体相互作用 |
| 数据深度 | 广度优先,深度不一 | 深度极佳,数据标准化程度高,置信度打分 | 深度极佳,提供详细的结合亲和力数据 |
| 特色功能 | 3D相似性搜索、专利整合、通路数据 | 强大的API、标准化生物活性数据(pChEMBL值) | 提供蛋白-配体共晶结构信息 |
| 易用性 | 界面友好,适合探索式浏览 | 结构清晰,API强大,适合编程和分析 | 界面简洁,查询直接 |
评测:PubChem的策略是“海纳百川”,将ChEMBL、BindingDB等专业数据库的数据都整合进来,形成一个超级入口。虽然其单个数据的深度和标准化程度可能不及ChEMBL,但其无与伦比的广度,使其成为启动任何化学生物学课题的最佳起点。你可以先在PubChem上快速扫描全局,再进入ChEMBL等专业库进行精细化分析。
3. 杀手级功能三:全面的专利与文献链接
化学信息的价值不仅在于其物理属性,更在于其知识产权的归属和应用。PubChem在整合专利和文献方面的能力,使其成为连接基础科研与产业应用的关键桥梁。
功能介绍与操作步骤:
以查找“司美格鲁肽”(Semaglutide,一种GLP-1受体激动剂,用于治疗2型糖尿病和肥胖症)的相关专利为例:
- 在PubChem中搜索“Semaglutide”,进入其Compound Summary页面。
- 向下滚动,找到 “Patents” 板块。这里会列出由Google Patents等数据源提供的,提及司美格鲁肽的专利列表。
- 你可以看到专利标题、摘要片段、专利权人(如Novo Nordisk A/S)以及专利ID。
- 点击感兴趣的专利链接,即可直接跳转到Google Patents页面,查看完整的专利全文,包括权利要求、制备方法和用途。
- 同样,在 “Literature” 板块,聚合了来自PubMed的超过4500万篇文献和引用关系。你可以看到哪些论文提到了司美格鲁肽,并直接链接到PubMed阅读摘要或全文。
最佳实践与常见误区:
- 最佳实践:
- 药物专利全景分析:在立项一个新药项目前,通过PubChem快速浏览目标靶点的相关专利,了解竞争对手的布局和核心分子的保护范围,避免侵权风险。
- 寻找合成路线:专利的“实施例”部分通常包含详细的化合物制备方法。通过PubChem的专利链接,你可以快速找到某个分子的公开合成路线。
- 追踪技术演进:通过“Co-occurrence Panels”(共现面板),分析某个化学物质与特定疾病或基因在文献和专利中的共提及频率,追踪其研究热度的变化趋势。
- 常见误区:
- 认为覆盖了所有专利:PubChem的专利数据主要来自Google Patents等公开源,可能存在时滞或覆盖不全的情况。对于核心的专利布局分析,仍需结合Derwent Innovation等专业专利数据库。
- 只看标题不看权利要求:专利的保护范围由权利要求书决定,而非标题。务必点击链接查看全文,进行深入分析。
功能对比:PubChem vs SciFinder-n vs Google Patents
| 功能维度 | PubChem | SciFinder-n | Google Patents |
|---|---|---|---|
| 专利整合方式 | 以化合物为中心聚合,提供链接 | 深度整合,支持Markush结构检索和分析 | 以专利文献为中心,全文搜索 |
| Markush检索 | 不支持 | 核心功能,是专利检索的黄金标准 | 不支持 |
| 文献来源 | PubMed | CAplus (包含期刊、专利、会议论文等,范围更广) | 仅限专利 |
| 分析工具 | 基础共现分析 | 强大的专利地图、全景分析工具 | 基础搜索 |
| 价格 | 免费 | 极其昂贵 | 免费 |
评测:PubChem的专利和文献功能,其核心价值在于 “连接” 。它让你在研究一个化学分子时,能无缝地切换到它的知识产权和学术文献背景中去。对于绝大多数科研人员和中小型企业来说,这个免费功能已经能解决80%的信息关联需求。只有当你需要进行专业的、法律级别的专利查新或全面的专利布局分析时,才需要投入成本使用SciFinder-n。
4. 差异化特色功能:PubChemRDF与云端部署
如果说前面的功能是“应用层”的杀手锏,那么PubChemRDF就是“数据层”的核武器。这是PubChem与所有其他化学数据库最根本的不同点,也是其技术前瞻性的体现。
功能介绍:
RDF(Resource Description Framework,资源描述框架)是语义网的标准数据模型。PubChem将其所有数据(化合物、物质、生物测定、蛋白、基因、通路等)都映射并公开为RDF格式。这意味着,PubChem的数据不再是孤立的字符串和数字,而是一个巨大的、相互关联的知识图谱。每一个CID、每一个靶点、每一篇文献都是一个实体,它们之间的关系(例如:“化合物X has_bioactivity 测定Y”、“测定Y targets 蛋白Z”)都被明确定义。
为什么这个功能让它脱颖而出:
- 机器的可读性:传统数据库是为“人读”设计的,你需要下载表格,手动分析。而RDF数据是为“机读”设计的。计算机程序可以直接理解和推理这些数据。
- 促进数据整合:使用SPARQL查询语言,你可以轻松地将PubChem的数据与你自己的内部数据或其他公开的语义数据集(如UniProt、ChEMBL的RDF版本)进行联合查询。例如,你可以写一个查询:“找出所有同时靶向激酶A和激酶B,且分子量小于500的化合物,并列出它们的供体氢键数目”。这种跨数据库的复杂查询,在传统架构下极其困难,而在语义网架构下则变得简单。
- 云端可访问性:正如PubChem在2026年5月发布的最新论文《PubChemRDF on the Google Cloud Platform》所述,他们已将海量的RDF数据集部署到谷歌云平台(GCP)上。这意味着,任何研究人员都无需自己下载和处理TB级别的原始数据,而是可以直接在云端通过BigQuery等标准工具,以极低的成本对PubChem全库进行大规模数据挖掘和分析。这彻底解决了“大数据可用性”的最后一公里问题。
详细对比说明:
与SciFinder或Reaxys等封闭的商业数据库相比,PubChemRDF的开放性和互操作性是其降维打击的武器。商业数据库的价值在于其人工标引的高质量数据和强大的分析工具,但它们的数据是“封闭花园”,难以与外部世界自由连接。PubChem则选择了一条“开放高速公路”的道路,虽然数据本身的精细度可能不及商业库,但它允许全球的开发者、数据科学家基于这个开放的基础设施,构建出无数种创新的应用和分析方法。这种平台化的思维,是PubChem最核心的差异化竞争力。
5. 针对高级用户的隐藏技巧
对于希望将PubChem价值榨干的深度用户,以下几个技巧是必学的:
- PUG-REST API的高级用法:大多数用户只用API来获取单个化合物的属性。高手会利用它进行批量操作和异步请求。
- 技巧:使用PUG-REST的
standardize操作。输入任意SMILES,API可以返回其标准化的互变异构体、中和形式等,这对于在构建内部数据库前清洗化学结构至关重要。 - 技巧:利用
property操作中的JSON输出,结合Python的pandas库,可以一键获取并分析数万个化合物的分子指纹、描述符和预测性质,快速构建机器学习模型的训练集。
- 技巧:使用PUG-REST的
- 直接通过FTP下载全库数据:对于需要构建本地化学信息系统的机构,PubChem提供了FTP服务,允许直接下载所有化合物的SDF、SMILES文件,以及完整的生物活性数据表。这是进行大规模化学信息学计算的起点。
- 利用Classification Browser进行化学空间导航:不要总用搜索框。PubChem的分类浏览器(Classification Browser)允许你按MeSH(医学主题词表)、ChEBI本体等层级分类,像翻阅图书一样浏览化学世界。例如,你可以展开“Chemical Actions and Uses” -> “Pharmacologic Actions” -> “Hypoglycemic Agents”,系统性地浏览所有已知的降血糖药物,这是一种发现新关联的强大方式。
- 巧用Co-occurrence Panels进行知识发现:在任何一个化合物的页面,找到“Co-occurrence”板块。它会列出与该化合物在文献和专利中共同提及最多的基因、疾病和生物体。这常常能揭示出意想不到的联系,为药物新适应症发现或毒理学研究提供线索。例如,一个原本用于心血管疾病的药物,其共现面板中频繁出现“Alzheimer Disease”,这可能提示其具有治疗阿尔茨海默症的潜力。
6. 功能完整度评估
为了给你一个宏观的视角,以下是PubChem核心功能的完整度评估表:
| 功能模块 | 支持情况 | 详细说明与替代方案 |
|---|---|---|
| 化学结构搜索 | ✅ 强大 | 支持精确、子结构、超结构、2D/3D相似性搜索。 |
| 生物活性数据 | ✅ 全面 | 聚合了2.99亿条数据,提供以靶点和化合物为中心的视图。 |
| 专利信息整合 | ✅ 良好 | 链接至Google Patents,提供基础检索,不支持Markush检索。替代:SciFinder-n。 |
| 文献关联 | ✅ 良好 | 聚合自PubMed,提供共现分析。替代:更专业的文献计量工具。 |
| 理化性质预测 | ✅ 良好 | 提供大量实验和预测数据(如LogP, pKa等),预测模型透明。 |
| 安全与毒性数据 | ✅ 良好 | 聚合来自EPA、NTP、ECHA等机构的SDS和毒性数据链接,但非原始数据库。替代:直接访问ECHA、EPA官网。 |
| 光谱数据 | ⚠️ 有限 | 收录部分实验光谱(NMR, IR, MS),但覆盖面远不如商业库。替代:SciFinder-n, Reaxys, SDBS。 |
| 合成路线 | ⚠️ 有限 | 提供合成相关的文献和专利链接,但无逆合成分析工具。替代:SciFinder-n, Reaxys。 |
| 供应商信息 | ✅ 强大 | 提供来自数百家供应商的化学品目录链接,方便采购。 |
| API编程访问 | ✅ 强大 | PUG-REST和PUG-View功能完善,支持JSON/XML等格式。 |
| 批量数据下载 | ✅ 强大 | 支持FTP全库下载、RDF下载和云端访问(GCP)。 |
| 3D结构查看与处理 | ✅ 良好 | 内置3D查看器,支持多种格式导出。 |
| Markush结构检索 | ❌ 不支持 | 专利中通用结构的检索核心。必须使用SciFinder-n。 |

五、 真实使用体验与深度测评
基于长期的追踪和使用,以下是对PubChem数据库的真实体验评测,力求客观。
1. 交互体验与UI设计
PubChem的界面设计哲学是“功能驱动”而非“设计驱动”。它没有花哨的动画和前沿的UI风格,而是以清晰的信息架构和高效的检索为核心。2025年的版本更新进一步优化了搜索体验,使结果展示更清晰。
- 优点:Compound Summary页面是其设计的精髓。它将海量的信息(从结构式、性质、生物活性到文献专利)组织在一个长页面中,通过清晰的锚点导航,用户可以快速跳转。这种“一站式仪表盘”的设计非常适合研究人员快速吸收信息。PubChem Sketcher绘图器反应灵敏,上手简单。
- 缺点:对于习惯了现代SaaS产品极简风格的年轻用户,可能会觉得界面信息密度过高,略显拥挤。某些高级功能的入口不够直观,需要阅读帮助文档才能发现。此外,作为一个面向全球的数据库,其汉化程度有限,对中文用户不够友好,存在一定的语言门槛。
2. 性能与响应速度实测
作为美国政府机构运营的网站,PubChem的基础设施非常稳固。
- 常规搜索:通过名称或CID搜索化合物,响应速度通常在1秒以内,非常迅速。
- 结构搜索:子结构和相似性搜索的性能取决于结构的复杂度和特异性。一个简单的苯环子结构搜索,结果可能高达数百万,但PubChem的分页和过滤机制能保证前几页结果的快速加载(<3秒)。复杂的3D相似性搜索计算量较大,可能需要十几秒甚至更长时间,但考虑到其计算规模,这个速度完全可以接受。
- API调用:PUG-REST API的同步请求响应迅速,适合自动化脚本。对于大规模任务,使用异步请求模式(返回任务ID,轮询结果)是标准做法,稳定可靠。
- 稳定性:在多年的使用中,极少遇到服务宕机。作为国家级的关键科研基础设施,其SLA(服务水平协议)有隐性但坚实的保障。
3. PubChem数据库优缺点对比
核心优势:
- 无可比拟的免费与开放性:这是PubChem的基石。它消除了信息获取的经济壁垒,对全球科研民主化产生了深远影响。
- 数据体量巨大,覆盖面广:1.23亿化合物、3.47亿物质、1114个数据源,使其成为化学信息的“谷歌”。
- 独特的化学生物学整合能力:以Protein/Gene/Pathway为中心的生物学数据聚合,是连接化学与生物学的强大桥梁,这在其他数据库中极为罕见。
- 强大的3D相似性搜索:免费提供基于形状和药效团的3D搜索,是骨架跃迁和新分子发现的利器。
- 先进的数据可访问性:PubChemRDF和云端部署代表了数据库的未来,为大数据和AI应用提供了无与伦比的舞台。
- 权威的数据来源:由NIH/NCBI维护,数据来源可追溯,是值得信赖的科研级资源。
- 强大的API和批量下载能力:为程序化访问和本地化集成提供了完善的支持。
- 持续更新与演进:从2004年至今,每月都有新数据源和新功能加入,保持着旺盛的生命力。
不足之处:
- 数据深度与标准化有待提升:由于是聚合器,数据质量参差不齐。生物活性数据的标准化程度不如ChEMBL,存在重复、矛盾或单位不一致的情况,使用时需要自行清洗和判断。
- 缺乏关键的专业级功能:不支持Markush结构检索,没有逆合成分析工具,光谱数据有限。这使得它在某些专业领域的深度应用中,无法完全替代SciFinder或Reaxys。
- 界面和语言的亲和力不足:信息密度高,学习曲线略陡峭,且对非英语用户不够友好。虽然这些因素在可接受范围内,但仍有改进空间。
- 搜索结果的相关性排序:有时,通过名称搜索一个常见药物,排名第一的可能是其某个不常见的同位素或盐形式,而非其母体分子。结果的排序算法不如商业搜索引擎那么“智能”。
点评:尽管存在这些不足,但它们更像是“白璧微瑕”。对于一个免费数据库而言,PubChem所提供的价值已经远超其存在的缺点。这些不足大多是因为其“公共聚合器”的定位所限,而非技术的缺陷。在绝大多数场景下,它依然是科研工作者的首选起点和不可或缺的工具。
六、 价格方案与性价比分析
1. 免费版 vs 付费版区别
这是PubChem最令人振奋的章节。简单来说,不存在付费版。
| 对比维度 | PubChem | 典型商业数据库 (如SciFinder-n) |
|---|---|---|
| 访问费用 | 完全免费 | 极其昂贵(年费可达数万至数十万美元) |
| 功能限制 | 无。所有功能(搜索、下载、API)对所有用户开放 | 按订阅级别开放不同功能模块 |
| 用户支持 | 文档、教程、邮件列表 | 专属客户经理、培训、技术支持 |
| 数据下载 | 无限制批量下载、FTP、API | 通常有严格的下载限制或高额附加费 |
| 价值主张 | 公共知识服务,促进科学进步 | 生产力工具,提供深度精选数据和高级分析 |
PubChem的资金来源于美国纳税人的税金,其使命就是让所有人都能自由获取化学信息。因此,你无需担心任何隐藏费用、订阅陷阱或功能阉割。
2. 哪个套餐最值得买?
没有套餐可选,所以这个问题变成了:如何最大化利用这个免费资源?
最佳购买建议是:将你的时间和学习成本,投入到学习如何使用它的API、了解其数据结构、掌握高级搜索技巧上。 这笔“投资”将为你带来远超任何付费数据库的长期回报。
3. 有无隐藏费用或退款政策?
完全没有隐藏费用。没有退款政策,因为根本没有收费项目。你可以放心大胆地使用,无需提供信用卡信息,也永远不会收到账单。
七、 竞品横向对比
为了帮助你做出更明智的选择,我们将PubChem与5个主要竞品进行多维度对比。
1. 竞品横向对比总表
| 对比维度 | PubChem | SciFinder-n | Reaxys | ChEMBL | DrugBank | Wikipedia (化学) |
|---|---|---|---|---|---|---|
| 价格 | 免费 | 付费(极贵) | 付费(极贵) | 免费 | 免费增值 | 免费 |
| 化合物数量 | 1.23亿 | 2.04亿物质 | 数千万 | ~240万 | ~1.4万 (药物/候选物) | 数千(高质量条目) |
| 核心优势 | 体量与开放性 | 专利Markush检索、逆合成 | 反应数据、逆合成 | 标准化生物活性数据 | 深度药物知识 | 易读性、公众普及 |
| 生物活性数据 | 2.99亿 (广度优先) | 有,整合自文献 | 有,整合自文献 | 1500万+ (深度优先) | 有,靶点导向 | 无系统数据 |
| 专利检索 | 基础链接 | 黄金标准 | 良好 | 无 | 无 | 无 |
| 合成路线 | 文献链接 | 逆合成规划器 | 逆合成规划器 | 无 | 无 | 无 |
| API/数据下载 | 非常强大 | 受限 | 受限 | 强大 | 良好 | 受限 |
| 易用性 | 中等 | 中等(需学习) | 中等(需学习) | 高 | 高 | 极高 |
| 目标用户 | 所有科研人员 | 合成化学家、专利律师 | 合成化学家 | 化学生物学家、药物发现 | 药师、临床医生、药理学家 | 公众、学生 |
2. 选购决策树
基于以上对比,你可以根据以下决策路径来选择最适合你的工具:
问题1:你的核心任务是否涉及专利查新、规避或全面的专利布局?
- 是 -> SciFinder-n。其Markush检索是不可替代的。
- 否 -> 进入问题2。
问题2:你的核心任务是否是设计全新的、可行的合成路线?
- 是 -> SciFinder-n 或 Reaxys。它们的逆合成分析工具是行业标准。
- 否 -> 进入问题3。
问题3:你的研究是否高度依赖高质量、标准化的生物活性数据(如构建QSAR模型)?
- 是 -> ChEMBL。其数据经过精心整理,置信度高。可以配合PubChem使用,用PubChem发现,用ChEMBL精炼。
- 否 -> 进入问题4。
问题4:你是否需要深度、专业的临床药物信息(如详细的药理学、相互作用、临床试验)?
- 是 -> DrugBank。它在药物深度知识方面无出其右。
- 否 -> PubChem 就是你最全能、最强大的免费起点。对于所有其他化学信息检索、探索、数据挖掘和教学任务,它都是最佳选择。
八、 常见问题解答
1. PubChem上的数据可靠吗?我可以直接引用吗?
PubChem本身是一个数据聚合器,其数据的可靠性取决于原始数据源。它整合了来自1114个权威机构的数据,如EPA、NTP、FDA、ChEMBL、各大期刊和专利局。因此,大部分数据是高度可靠的。你可以并且应该引用PubChem。官方提供了明确的引用指南,通常建议引用具体的Compound Summary页面和其原始数据源。但在进行关键性研究或法规提交时,最佳实践是追溯并核实原始数据源,而非仅仅依赖PubChem的聚合信息。
2. PubChem和SciFinder有什么区别?我该用哪个?
这是一个经典问题。核心区别在于:PubChem是免费的公共图书馆,SciFinder是昂贵的专业工作室。
- 用PubChem:当你需要快速、免费地获取一个化合物的基本信息、寻找类似物、进行大规模的生物活性数据挖掘、或通过API构建自己的应用时。
- 用SciFinder:当你需要进行决定性的专利查新(特别是Markush结构)、设计复杂分子的逆合成路线、或需要最深度、最权威的文献标引时。
对于大多数科研人员和学生,从PubChem开始你的研究是最高效、最经济的选择。只有在遇到其功能边界时,才需要考虑投入成本使用SciFinder。
3. 如何通过PubChem查找化学品的安全技术说明书(SDS)?
非常直接。在PubChem中搜索该化学品的名称或CAS号,进入其Compound Summary页面。在页面目录中找到并点击 “Safety and Toxicity” 或 “Chemical Safety” 部分。你会看到来自多个源的安全数据链接,其中通常包括 “Laboratory Chemical Safety Summary (LCSS)”。这个LCSS是由PubChem整理的,聚合了来自多家权威机构的关键安全和毒性信息,可以看作一个简版的SDS。页面下方通常还会提供直接指向原始SDS数据库(如供应商或监管机构网站)的外部链接。
九、 结论与下一步行动
PubChem数据库不仅仅是一个工具,它更是一种科学基础设施,一种“知识平权”的理念化身。它以无与伦比的体量、深度和开放性,重塑了化学、生物学及相关领域的信息获取方式。从学生课堂上的好奇发问,到顶尖实验室里的前沿药物发现,它都在背后默默提供着强大而免费的支撑。它的杀手级功能——多维结构搜索、目标导向的生物学数据聚合、以及前瞻性的云端RDF数据架构——共同构筑了其难以逾越的竞争壁垒。
诚然,它在专利Markush检索、逆合成分析等专业领域的深度上,尚无法取代昂贵的商业数据库。其界面和信息密度也对新手构成了一定的挑战。但这些“不足之处”,在其“免费”这个绝对优势面前,显得瑕不掩瑜。它是你探索化学世界时,永远应该第一个打开,并且值得你投入时间去深入学习的资源。
最终评分:9.5 / 10
(扣掉的0.5分,是对其未来在数据深度标准化和用户体验上更进一步的期待。)
你的下一步行动:
不要再把PubChem仅仅当作一个查分子量的工具了。打开浏览器,访问PubChem,选择一个你最近正在研究的靶点或化合物,尝试使用本文介绍的Protein数据集合或3D相似性搜索功能。去申请一个API Key,尝试用几行Python代码获取一批数据。去探索它的FTP服务器,感受一下拥有1.23亿个化学结构数据集是怎样的体验。真正挖掘出这座免费宝藏的潜力,让你的研究和学习效率,进入一个全新的量级。
相关导航
没有相关内容!
暂无评论...